"title": "Monitoring Saja Tidak Cukup: Apa Itu Observability dan Mengapa Perusahaan Membutuhkannya?",
"slug": "observability-penting-perusahaan-modern",
"focus_keyphrase": "Monitoring",
"proactive problem solving",
"seo_title": "Observability vs. Monitoring: Mengapa Perusahaan Membutuhkannya?",
"meta_description": "Monitoring tradisional tak lagi cukup. Pelajari apa itu Observability, perbedaannya dengan monitoring, dan mengapa ini krusial bagi kelangsungan bisnis Anda. Tingkatkan MTTR dan pengalaman pelanggan.",
"excerpt": "Monitoring tradisional seringkali terbatas pada 'apa yang salah', namun Observability menjawab 'mengapa itu salah' dengan insight mendalam. Ini adalah kunci bagi perusahaan modern untuk memahami sistem kompleks dan bertindak proaktif, bukan hanya reaktif.",
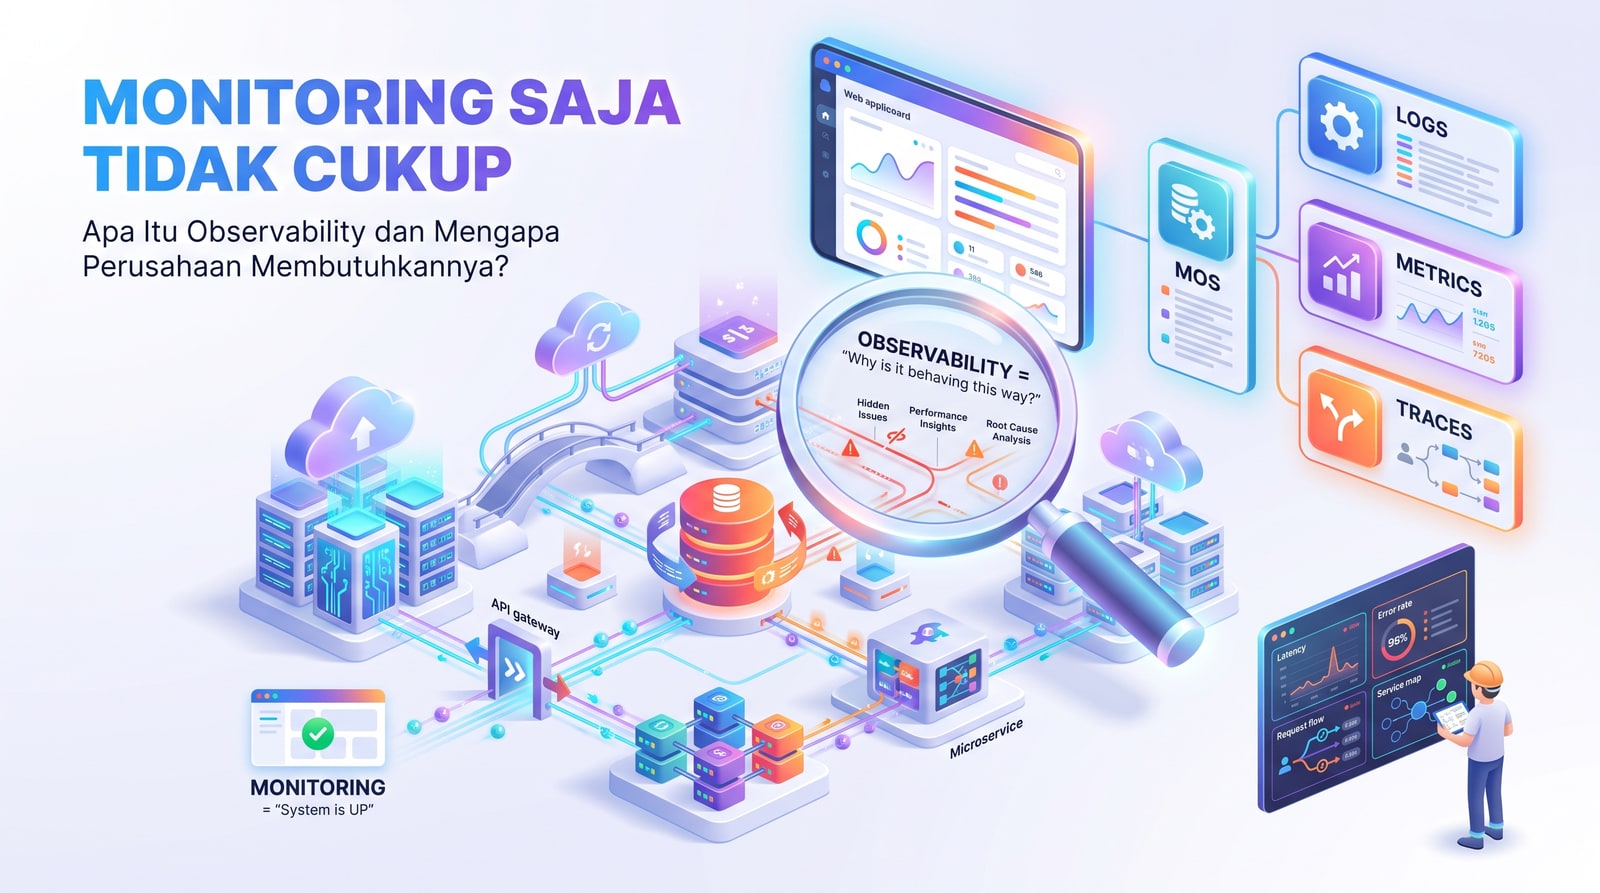
"cover_image_alt": "Infografis perbandingan observability dan monitoring untuk sistem enterprise",
"category_suggestion": "Teknologi",
"content_markdown": "Dalam lanskap teknologi modern yang didominasi arsitektur microservices dan cloud-native, monitoring saja tidak lagi memadai untuk memahami dan mengelola kompleksitas sistem. Observability adalah kemampuan untuk menyimpulkan kondisi internal sistem dengan memeriksa data yang dihasilkannya (metrics, logs, traces), memungkinkan tim mengidentifikasi akar masalah yang tidak terduga dan membuat keputusan operasional yang lebih cerdas.\n\n> Ringkasan Utama:\n> Monitoring vs. Observability: Monitoring berfokus pada metrik yang sudah dikenal untuk 'apa yang terjadi', sementara Observability memungkinkan pemahaman 'mengapa itu terjadi' bahkan untuk masalah yang belum pernah terjadi.\n> Pilar Utama: Observability dibangun di atas tiga pilar data utama: Metrics (data teragregasi), Logs (catatan peristiwa individual), dan Traces (alur permintaan lintas layanan).\n> Manfaat Bisnis: Meningkatkan Mean Time To Resolution (MTTR), mengurangi downtime, mempercepat inovasi, dan meningkatkan pengalaman pengguna secara signifikan.\n> Tantangan Implementasi: Membutuhkan investasi pada tools, perubahan budaya tim, dan strategi data yang matang untuk menghindari kelebihan informasi.\n> Kebutuhan Mendesak: Penting untuk sistem terdistribusi modern agar tim dapat proaktif menghadapi 'unknown unknowns' dan memastikan kelangsungan layanan.\n\n## Apa Perbedaan Mendasar antara Monitoring dan Observability?\n\nPerbedaan mendasar antara monitoring dan observability terletak pada kedalaman dan jenis wawasan yang mereka berikan: monitoring memberi tahu 'apa yang salah' atau 'apa yang terjadi', sementara observability memungkinkan kita menemukan 'mengapa itu terjadi' dan bahkan 'apa yang mungkin terjadi selanjutnya'. Monitoring beroperasi berdasarkan asumsi 'known unknowns', yaitu masalah yang sudah kita antisipasi dan definisikan metriknya, seperti penggunaan CPU tinggi atau disk penuh. Ini seperti lampu indikator di dashboard mobil yang menyala ketika ada masalah yang sudah diprogram.\n\nObservability, di sisi lain, dirancang untuk 'unknown unknowns'—masalah yang tidak terduga atau pola perilaku sistem yang aneh yang muncul dari interaksi kompleks komponen. Ini seperti memiliki kemampuan untuk membongkar mesin mobil secara virtual dan melihat setiap bagiannya berfungsi secara real-time, bahkan ketika tidak ada lampu peringatan yang menyala. Dengan observability, tim dapat mengajukan pertanyaan baru tentang sistem dan mendapatkan jawaban yang relevan dari data yang dikumpulkan, bukan hanya dari metrik yang telah ditentukan sebelumnya. Ini sangat krusial dalam arsitektur modern seperti microservices, di mana interaksi antar-layanan bisa sangat dinamis dan sulit diprediksi.\n\n### Monitoring: Batasan Pendekatan Tradisional\n\nMonitoring tradisional, meskipun esensial, memiliki batasan signifikan di lingkungan komputasi modern. Umumnya, monitoring melibatkan pengumpulan metrik dan log yang telah didefinisikan sebelumnya dari sistem dan aplikasi. Alat monitoring akan memicu peringatan (alerts) ketika metrik-metrik ini melampaui ambang batas tertentu, seperti latensi API yang meningkat drastis atau jumlah error yang melonjak. Pendekatan ini sangat efektif untuk masalah yang sudah diketahui dan dapat diprediksi. Misalnya, tim IT dapat dengan mudah mengonfigurasi peringatan untuk penggunaan CPU di atas 80% atau memori yang hampir habis. Ini memberikan pandangan reaktif yang baik terhadap kesehatan sistem secara umum.\n\nNamun, monitoring menjadi kurang efektif ketika menghadapi sistem yang sangat terdistribusi dan dinamis, seperti arsitektur microservices di cloud. Di sini, kegagalan mungkin bukan disebabkan oleh satu komponen yang melebihi ambang batas, melainkan oleh interaksi kompleks antar-layanan, masalah konfigurasi yang halus, atau pola beban kerja yang tidak biasa. Monitoring tradisional seringkali gagal memberikan konteks yang cukup untuk memahami akar penyebab masalah tersebut. Tim mungkin tahu bahwa ada masalah, tapi tidak punya data yang memadai untuk memahami mengapa itu terjadi, apalagi untuk memperbaikinya dengan cepat. Ini yang menyebabkan Mean Time To Resolution (MTTR) menjadi lebih panjang dan frustrasi bagi tim operasional.\n\n### Observability: Kekuatan untuk Memahami 'Mengapa'\n\nObservability melampaui monitoring dengan menyediakan kemampuan untuk secara aktif mengeksplorasi kondisi internal sistem berdasarkan data eksternal yang dikeluarkannya. Ini bukan hanya tentang mengumpulkan data, tetapi tentang merancang sistem agar datanya dapat dipertanyakan dan memberikan wawasan mendalam. Dengan observability, tim dapat mengajukan pertanyaan ad-hoc tentang sistem yang sedang berjalan, bahkan untuk skenario yang tidak pernah mereka antisipasi sebelumnya. Ini melibatkan pengumpulan dan korelasi tiga jenis data telemetri utama: metrics, logs, dan traces.\n\nMisalnya, jika sebuah layanan mengalami perlambatan intermiten, monitoring mungkin hanya menunjukkan peningkatan latensi. Observability, dengan menggabungkan data dari logs (melihat error atau anomali), metrics (melihat perubahan pada database atau network I/O), dan traces (melacak jalur permintaan melalui berbagai layanan), dapat membantu tim dengan cepat mengidentifikasi bahwa perlambatan itu disebabkan oleh query database yang tidak efisien di layanan X, yang hanya dipicu oleh kombinasi parameter tertentu dari layanan Y. Kemampuan untuk memahami hubungan sebab-akibat yang kompleks ini adalah inti dari nilai observability, memungkinkan tim untuk bergerak dari reaksi ke diagnosis proaktif dan pencegahan.\n\n| Fitur / Aspek | Monitoring | Observability |\n| :------------------ | :--------------------------------------------- | :--------------------------------------------- |\n| Tujuan Utama | Mengetahui 'apa' yang terjadi (gejala) | Mengetahui 'mengapa' terjadi (akar masalah) |\n| Fokus Data | Metrik yang telah ditentukan, log terbatas | Metrics, Logs, Traces (data telemetri kaya) |\n| Pendekatan | Reaktif, berbasis ambang batas (thresholds) | Proaktif, eksplorasi ad-hoc, korelasi data |\n| Masalah Ditangani | 'Known Unknowns' (masalah yang diprediksi) | 'Unknown Unknowns' (masalah tak terduga) |\n| Wawasan | Kondisi permukaan, kesehatan umum | Kondisi internal, perilaku sistem mendalam |\n| Kompleksitas Sistem | Cocok untuk sistem monolitik/sederhana | Penting untuk sistem terdistribusi/cloud-native |\n| MTTR (Mean Time To Resolution) | Cenderung lebih tinggi | Cenderung lebih rendah |\n\n## Mengapa Observability Menjadi Kebutuhan Esensial bagi Perusahaan Modern?\n\nObservability menjadi kebutuhan esensial karena kompleksitas sistem digital modern telah melampaui kemampuan monitoring tradisional, menuntut kemampuan perusahaan untuk memahami perilaku internal sistem secara mendalam demi menjaga kelangsungan bisnis dan mempercepat inovasi. Dalam lingkungan di mana aplikasi dibangun dari ratusan bahkan ribuan microservices yang berinteraksi di berbagai infrastruktur cloud, titik kegagalan bisa sangat banyak dan saling terkait. Tanpa observability, tim operasional akan menghabiskan waktu berjam-jam atau bahkan berhari-hari hanya untuk mendiagnosis masalah, yang berujung pada downtime yang mahal dan hilangnya kepercayaan pelanggan.\n\nBagi Product Manager dan Designer, observability bukan sekadar alat teknis, melainkan jembatan untuk memahami bagaimana produk mereka berkinerja di tangan pengguna nyata dan bagaimana infrastruktur mendukung pengalaman tersebut. Dengan wawasan dari observability, mereka dapat mengidentifikasi bottleneck kinerja yang memengaruhi UX, memvalidasi dampak fitur baru, dan bahkan menginformasikan keputusan desain produk berikutnya. Ini memungkinkan perusahaan untuk tidak hanya bereaksi terhadap masalah, tetapi juga secara proaktif mengoptimalkan sistem, mengurangi risiko, dan mendorong inovasi dengan kepercayaan diri yang lebih tinggi. Perusahaan yang mengabaikan observability berisiko tertinggal dalam persaingan, menghadapi biaya operasional yang lebih tinggi, dan kehilangan peluang di pasar yang serba cepat.\n\n### Dampak pada Bisnis dan Pengalaman Pengguna\n\nAdopsi observability memiliki dampak langsung dan signifikan pada metrik bisnis kunci serta pengalaman pengguna. Pertama dan terpenting, ia secara drastis mengurangi Mean Time To Resolution (MTTR). Sebuah studi oleh IDC menemukan bahwa organisasi dengan tingkat observability tinggi dapat mengurangi MTTR hingga 70%. Ini berarti ketika insiden terjadi, waktu yang dibutuhkan untuk mendeteksi, mendiagnosis, dan memperbaiki masalah berkurang dari jam menjadi hitungan menit. Pengurangan downtime ini secara langsung menyelamatkan pendapatan yang hilang dan melindungi reputasi brand. Bayangkan sebuah platform e-commerce yang mengalami downtime selama jam sibuk; setiap menit adalah kerugian finansial dan potensi hilangnya pelanggan seumur hidup.\n\nDari sisi pengalaman pengguna, observability memastikan bahwa aplikasi dan layanan berjalan optimal. Dengan kemampuan untuk dengan cepat mengidentifikasi dan memperbaiki masalah kinerja, perusahaan dapat mempertahankan Service Level Objectives (SLO) dan Service Level Agreements (SLA) yang ketat. Pengguna modern memiliki ekspektasi tinggi terhadap kecepatan dan keandalan; perlambatan atau kegagalan sekecil apa pun dapat membuat mereka beralih ke kompetitor. Observability juga memungkinkan tim untuk mengidentifikasi 'silent failures'—masalah yang tidak memicu peringatan tetapi secara perlahan mengikis kinerja atau pengalaman pengguna. Dengan demikian, observability bukan hanya tentang menjaga sistem tetap hidup, tetapi juga tentang memastikan sistem memberikan nilai maksimal kepada pengguna akhir.\n\n### Risiko Mengabaikan Observability\n\nMengabaikan observability di era digital ini sama dengan berlayar di lautan badai tanpa radar atau kompas. Risiko terbesar adalah ketidakmampuan untuk memahami apa yang sebenarnya terjadi di dalam sistem Anda saat masalah muncul. Ini menyebabkan MTTR yang sangat tinggi, di mana tim menghabiskan waktu berjam-jam atau bahkan berhari-hari untuk 'firefighting' tanpa kejelasan, seringkali hanya menerapkan perbaikan sementara yang tidak mengatasi akar masalah. Setiap menit downtime atau kinerja buruk berarti kerugian finansial, baik dari transaksi yang hilang, biaya operasional untuk perbaikan darurat, maupun potensi denda SLA.\n\nSelain itu, ada risiko reputasi yang substansial. Pelanggan modern berbagi pengalaman buruk dengan cepat melalui media sosial, yang dapat merusak citra merek yang dibangun bertahun-tahun dalam sekejap. Tim pengembangan dan operasional juga akan mengalami burnout karena terus-menerus menghadapi krisis tanpa alat yang memadai untuk diagnosis. Ini menghambat inovasi karena tim terlalu sibuk memperbaiki masalah yang ada daripada membangun fitur baru. Pada akhirnya, perusahaan yang tidak mengadopsi observability akan kesulitan bersaing, lambat berinovasi, dan rentan terhadap kegagalan sistem yang merugikan. A2M Jaya Teknologi dapat membantu Anda mengurangi risiko ini dengan solusi layanan kami yang terintegrasi.\n\n## Pilar-Pilar Utama Observability: Metrics, Logs, dan Traces\n\nObservability dibangun di atas fondasi tiga pilar data telemetri yang saling melengkapi: metrics, logs, dan traces. Masing-masing pilar ini menawarkan perspektif unik tentang kondisi dan perilaku sistem, dan ketika dikombinasikan, mereka memberikan gambaran yang komprehensif. Mengandalkan hanya satu atau dua pilar akan meninggalkan 'blind spots' yang dapat menghambat diagnosis masalah yang efektif. Memahami cara kerja dan manfaat masing-masing pilar adalah kunci untuk merancang strategi observability yang efektif.\n\n### Metrics: Gambaran Kuantitatif\n\nMetrics adalah data numerik yang diukur dan dikumpulkan secara berkala dari sistem atau aplikasi, memberikan gambaran kuantitatif tentang kinerja dan kesehatan sistem dari waktu ke waktu. Contoh umum metrics meliputi penggunaan CPU, pemanfaatan memori, jumlah permintaan per detik (RPS), latensi permintaan, dan tingkat kesalahan. Metrics biasanya dikumpulkan dalam interval waktu tertentu (misalnya, setiap 10 detik) dan disimpan dalam database time-series, memungkinkan visualisasi tren melalui dashboard seperti Grafana. Keunggulan metrics adalah efisiensinya dalam penyimpanan dan kemampuannya untuk diagregasi dan dianalisis secara cepat untuk mengidentifikasi pola atau anomali besar.\n\nNamun, metrics memiliki keterbatasan: mereka seringkali hanya memberitahu apa yang terjadi (misalnya, "latensi API meningkat"), tetapi jarang mengapa. Mereka adalah indikator, bukan penjelasan. Untuk mendapatkan detail lebih lanjut, kita perlu melengkapi metrics dengan pilar lainnya. Praktik terbaik untuk metrics meliputi:\n\n Standardisasi: Gunakan nama metrik yang konsisten di seluruh layanan.\n Kardinalitas Rendah: Hindari metrik dengan terlalu banyak label unik yang dapat membebani sistem penyimpanan.\n Konteks Bisnis: Sertakan metrik yang relevan dengan tujuan bisnis, bukan hanya teknis.\n Alerting Cerdas: Konfigurasi peringatan berdasarkan tren atau anomali, bukan hanya ambang batas statis.\n\n### Logs: Catatan Peristiwa Detil\n\nLogs adalah catatan tekstual dari peristiwa diskrit yang terjadi dalam sistem atau aplikasi pada waktu tertentu. Setiap entri log biasanya berisi timestamp, tingkat keparahan (info, warning, error), pesan, dan seringkali metadata tambahan seperti ID pengguna, ID sesi, atau nama layanan. Logs sangat berharga untuk debugging karena mereka menyediakan detail kontekstual yang granular tentang apa yang dilakukan aplikasi pada saat tertentu. Ketika sebuah error terjadi, log dapat menunjukkan urutan peristiwa yang mengarah ke error tersebut, termasuk nilai variabel atau kondisi sistem yang relevan.\n\nNamun, volume log bisa sangat besar, terutama di sistem terdistribusi, menjadikannya tantangan untuk disimpan, dicari, dan dianalisis secara efisien. Tanpa strategi yang tepat, tim dapat kewalahan oleh 'log noise'. Untuk mengatasi ini, strukturisasi log (misalnya, dalam format JSON) sangat direkomendasikan karena memungkinkan pengindeksan dan pencarian yang lebih canggih. Selain itu, penting untuk memiliki sistem manajemen log terpusat seperti ELK Stack (Elasticsearch, Logstash, Kibana) atau Splunk. Untuk mendapatkan wawasan lebih lanjut mengenai pengelolaan data log, Anda bisa membaca artikel lain di blog kami.\n\n### Traces: Alur Permintaan Lintas Layanan\n\nTraces, atau distributed traces, memvisualisasikan jalur lengkap sebuah permintaan saat melintasi berbagai layanan dan komponen dalam arsitektur terdistribusi. Setiap operasi dalam sebuah permintaan (misalnya, panggilan API, query database, pemrosesan pesan) disebut 'span'. Trace mengumpulkan semua span yang terkait dengan satu permintaan, menampilkannya dalam urutan kronologis dengan hubungan induk-anak. Ini memungkinkan tim untuk melihat dengan tepat berapa lama waktu yang dihabuhkan di setiap layanan dan mengidentifikasi bottleneck kinerja di seluruh tumpukan aplikasi.\n\nTraces sangat kuat untuk root cause analysis di microservices. Jika sebuah permintaan pengguna memakan waktu 5 detik dan melewati 10 layanan, trace akan menunjukkan layanan mana yang paling lama merespons atau di mana terjadi kesalahan. Tanpa traces, melacak masalah seperti itu akan menjadi pekerjaan detektif yang memakan waktu lama, melibatkan pemeriksaan log dari puluhan layanan secara manual. Implementasi tracing biasanya memerlukan instrumentasi kode dan penggunaan alat seperti Jaeger, Zipkin, atau OpenTelemetry. Tracing membantu Product Manager memahami pengalaman pengguna secara holistik dari sisi teknis, melihat di mana 'perjalanan' pengguna mungkin terhambat oleh kinerja sistem.\n\n## Membangun Budaya Observability: Langkah dan Tantangan Implementasi\n\nMembangun budaya observability bukan hanya tentang menginstal alat baru; ini adalah transformasi mendalam dalam cara tim memahami, memecahkan masalah, dan berinteraksi dengan sistem mereka. Langkah pertama adalah mengakui bahwa monitoring tradisional tidak lagi cukup dan bahwa investasi pada observability adalah investasi strategis untuk kelangsungan dan inovasi bisnis. Ini memerlukan dukungan dari manajemen puncak hingga tim teknis di lapangan. Proses implementasi harus melibatkan perubahan budaya, pelatihan, dan adopsi alat yang tepat secara bertahap.\n\nTantangan utamanya seringkali bukan teknis, melainkan organisasi dan budaya. Tim mungkin resisten terhadap perubahan, merasa terbebani oleh data baru, atau tidak yakin bagaimana cara menggunakan alat observability secara efektif. Estimasi biaya awal untuk alat dan pelatihan mungkin terlihat besar, tetapi Return on Investment (ROI) dari pengurangan downtime, peningkatan efisiensi tim, dan percepatan inovasi biasanya jauh lebih besar dalam jangka panjang. Sebuah studi oleh Forrester menemukan bahwa perusahaan yang berinvestasi pada observability dapat melihat ROI hingga 300% dalam tiga tahun, terutama melalui pengurangan biaya operasional dan peningkatan kepuasan pelanggan.\n\n### Langkah-Langkah Strategis Adopsi\n\nAdopsi observability yang sukses memerlukan pendekatan yang terstruktur:\n\n1. Evaluasi Kebutuhan: Mulai dengan mengidentifikasi 'pain points' terbesar dalam sistem Anda saat ini. Di mana MTTR paling tinggi? Masalah apa yang paling sering muncul dan sulit didiagnosis? Ini akan membantu memprioritaskan area untuk instrumentasi awal.\n2. Pilih Alat yang Tepat: Ada banyak pilihan, dari solusi open-source seperti Prometheus (metrics), Grafana (visualisasi), Jaeger (tracing), dan ELK Stack (logs), hingga platform komersial terintegrasi seperti Datadog, New Relic, atau Dynatrace. Pilihan Anda harus mempertimbangkan skala, anggaran, keahlian tim, dan kebutuhan integrasi. Solusi komersial sering menawarkan kemudahan penggunaan dan dukungan yang lebih baik, sementara open-source memberikan fleksibilitas dan kontrol penuh.\n3. Instrumentasi Sistem: Ini adalah langkah teknis yang paling intensif, melibatkan modifikasi kode aplikasi untuk memancarkan metrics, logs, dan traces. Gunakan pustaka instrumentasi standar seperti OpenTelemetry untuk memastikan portabilitas dan interoperabilitas. Prioritaskan layanan paling kritis terlebih dahulu.\n4. Bangun Dashboard dan Peringatan: Setelah data mengalir, buat dashboard yang relevan untuk memvisualisasikan kesehatan sistem dari berbagai perspektif (bisnis, operasional, teknis). Konfigurasi peringatan yang cerdas yang tidak hanya memberitahu 'apa', tetapi juga memberikan konteks yang mengarah pada 'mengapa'.\n5. Pelatihan dan Perubahan Budaya: Edukasi tim pengembangan, operasional, dan bahkan produk tentang cara menggunakan alat observability dan menafsirkan data. Dorong budaya 'blameless post-mortem' di mana kegagalan dilihat sebagai kesempatan belajar, bukan untuk menyalahkan. Ini adalah kunci sukses jangka panjang.\n6. Iterasi dan Optimasi: Observability adalah perjalanan berkelanjutan. Terus tinjau data, perbaiki instrumentasi, dan sesuaikan dashboard serta peringatan seiring berkembangnya sistem dan kebutuhan bisnis Anda.\n\n### Tantangan Umum dan Cara Mengatasinya\n\nImplementasi observability tidak selalu mulus. Beberapa tantangan umum yang sering dihadapi perusahaan meliputi:\n\n Data Overload: Terlalu banyak data telemetri tanpa strategi yang jelas dapat menyebabkan 'noise' dan membuat diagnosis lebih sulit daripada sebelumnya. Solusi: Terapkan strategi logging yang terstruktur, filter data yang tidak relevan, dan fokus pada metrik/log/trace yang paling penting untuk setiap layanan.\n Kesenjangan Keterampilan: Tim mungkin tidak memiliki keahlian yang diperlukan untuk mengimplementasikan atau menggunakan alat observability secara efektif. Solusi: Investasikan dalam pelatihan, fasilitasi berbagi pengetahuan antar tim, atau pertimbangkan untuk bekerja sama dengan ahli eksternal seperti A2M Jaya Teknologi yang menawarkan course dan konsultasi.\n Resistensi Budaya: Tim development mungkin melihat instrumentasi sebagai beban tambahan, sementara tim operasi mungkin tidak terbiasa dengan pendekatan proaktif. Solusi: Mulai dengan proyek percontohan kecil untuk menunjukkan nilai, komunikasikan manfaatnya secara jelas, dan libatkan semua pemangku kepentingan sejak awal.\n Biaya: Solusi observability, terutama yang komersial, bisa mahal. Solusi: Mulai dengan solusi open-source jika anggaran terbatas, atau pilih platform komersial dengan model harga yang skalabel. Fokus pada ROI jangka panjang dari pengurangan downtime dan peningkatan efisiensi.\n Tool Sprawl: Menggunakan terlalu banyak alat yang tidak terintegrasi dengan baik. Solusi: Pilih platform terintegrasi (jika memungkinkan) atau fokus pada standar terbuka seperti OpenTelemetry untuk memastikan interoperabilitas antar alat.\n\n## Studi Kasus Realistis: Observability dalam Aksi\n\nMari kita bayangkan sebuah perusahaan e-commerce menengah, "Toko Jaya", yang baru saja migrasi ke arsitektur microservices di cloud untuk meningkatkan skalabilitas dan kecepatan pengembangan. Setelah migrasi, tim Product Manager dan Designer mulai menerima keluhan sporadis dari pengguna tentang halaman keranjang belanja yang lambat memuat atau gagal checkout. Tim operasional mereka, yang masih mengandalkan monitoring tradisional, hanya melihat peningkatan latensi umum di beberapa endpoint API terkait keranjang belanja, tetapi tidak dapat pinpoint akar masalahnya.\n\nDengan monitoring tradisional, mereka tahu bahwa ada masalah, tetapi tidak punya petunjuk mengapa. Mereka mungkin menghabiskan berjam-jam memeriksa log dari setiap microservice secara manual, mencoba mereplikasi masalah, atau bahkan melakukan rollback tanpa memahami penyebabnya. MTTR untuk insiden semacam ini bisa mencapai 4-6 jam, menyebabkan hilangnya penjualan signifikan dan frustrasi pengguna. Product Manager mulai khawatir tentang dampak pada konversi dan retensi pelanggan, sementara Designer merasa desain UX mereka tidak didukung oleh kinerja sistem.\n\n### Solusi dengan Observability\n\nSetelah mengimplementasikan platform observability yang komprehensif (mengintegrasikan metrics, logs, dan traces), situasinya berubah drastis. Ketika keluhan serupa muncul lagi:\n\n1. Metrics: Dashboard observability segera menunjukkan lonjakan latensi pada microservice `cart-service` dan peningkatan jumlah koneksi ke database `product-db`. Ini memberikan petunjuk awal yang lebih spesifik daripada hanya "API lambat."\n2. Traces: Tim operasional menggunakan distributed tracing untuk melacak permintaan pengguna yang gagal. Trace menunjukkan bahwa sebagian besar waktu dihabiskan pada sebuah panggilan ke `product-service` yang kemudian melakukan query database ke `product-db`. Lebih spesifik lagi, sebuah span dalam trace menyoroti bahwa sebuah query SQL di `product-service` memakan waktu 3 detik, jauh lebih lama dari biasanya.\n3. Logs: Dengan menggunakan ID trace yang sama, tim dapat menyaring log dari `product-service` dan `product-db` pada waktu insiden. Mereka menemukan entri log peringatan yang menunjukkan "unoptimized query pattern detected" untuk sebuah query yang mengambil informasi stok. Ternyata, tim pengembangan baru saja meluncurkan fitur "rekomendasi produk terkait" yang secara tidak sengaja memicu query stok produk dalam jumlah besar saat halaman keranjang dimuat, menyebabkan n+1 query problem.\n\nDengan observability, tim dapat mendiagnosis masalah dalam waktu kurang dari 30 menit. Mereka tidak hanya tahu apa yang terjadi (keranjang lambat) tetapi juga mengapa (query tidak efisien di `product-service` karena fitur baru). Perbaikan dapat diterapkan dengan cepat (misalnya, mengoptimalkan query atau menerapkan caching), mengurangi MTTR dari berjam-jam menjadi kurang dari satu jam. Product Manager kini memiliki data konkret untuk memahami dampak kinerja pada fitur baru dan dapat bekerja sama dengan tim teknis untuk memastikan fitur dirancang dengan mempertimbangkan efisiensi. Ini adalah contoh nyata bagaimana observability mengubah pendekatan dari reaktif menjadi proaktif, menghemat waktu, uang, dan menjaga kepercayaan pelanggan.\n\n## Memilih Platform Observability yang Tepat untuk Bisnis Anda\n\nMemilih platform observability yang tepat adalah keputusan strategis yang memerlukan pertimbangan matang, karena akan mempengaruhi efisiensi operasional, kecepatan inovasi, dan bottom line bisnis Anda. Ada berbagai opsi di pasar, mulai dari solusi open-source yang dapat disesuaikan hingga platform komersial terintegrasi yang menawarkan fitur lengkap. Pilihan terbaik sangat tergantung pada ukuran perusahaan, kompleksitas sistem, anggaran, dan keahlian tim Anda. Penting untuk tidak hanya melihat fitur, tetapi juga bagaimana platform tersebut akan berintegrasi dengan ekosistem teknologi Anda yang sudah ada dan mendukung tujuan bisnis jangka panjang.\n\nKriteria utama dalam memilih platform harus mencakup skalabilitas (mampukah menangani pertumbuhan data Anda?), kemampuan integrasi (mendukung semua teknologi yang Anda gunakan?), kemudahan penggunaan (apakah tim Anda dapat dengan cepat menguasainya?), model biaya (sesuai anggaran dan dapat diprediksi?), serta dukungan komunitas atau vendor. Untuk konsultasi lebih lanjut tentang pemilihan platform yang sesuai dengan kebutuhan spesifik Anda, jangan ragu untuk menghubungi kami.\n\n### Kriteria dan Pertimbangan Utama\n\nBerikut adalah beberapa kriteria penting saat mengevaluasi platform observability:\n\n Skalabilitas: Pastikan platform dapat menangani volume data telemetri Anda saat ini dan di masa depan tanpa penurunan kinerja atau biaya yang tidak terkontrol. Sistem terdistribusi menghasilkan data dalam jumlah besar, dan platform harus mampu mengindeks, menyimpan, serta menganalisisnya secara efisien.\n Kemampuan Integrasi: Platform harus dapat mengumpulkan data dari berbagai sumber: aplikasi (berbagai bahasa pemrograman), infrastruktur (cloud provider, Kubernetes), database, dan layanan pihak ketiga. Dukungan untuk standar terbuka seperti OpenTelemetry adalah nilai tambah yang besar.\n* Fitur Analisis dan Visualisasi: Cari platform yang menawarkan dashboard yang fleks