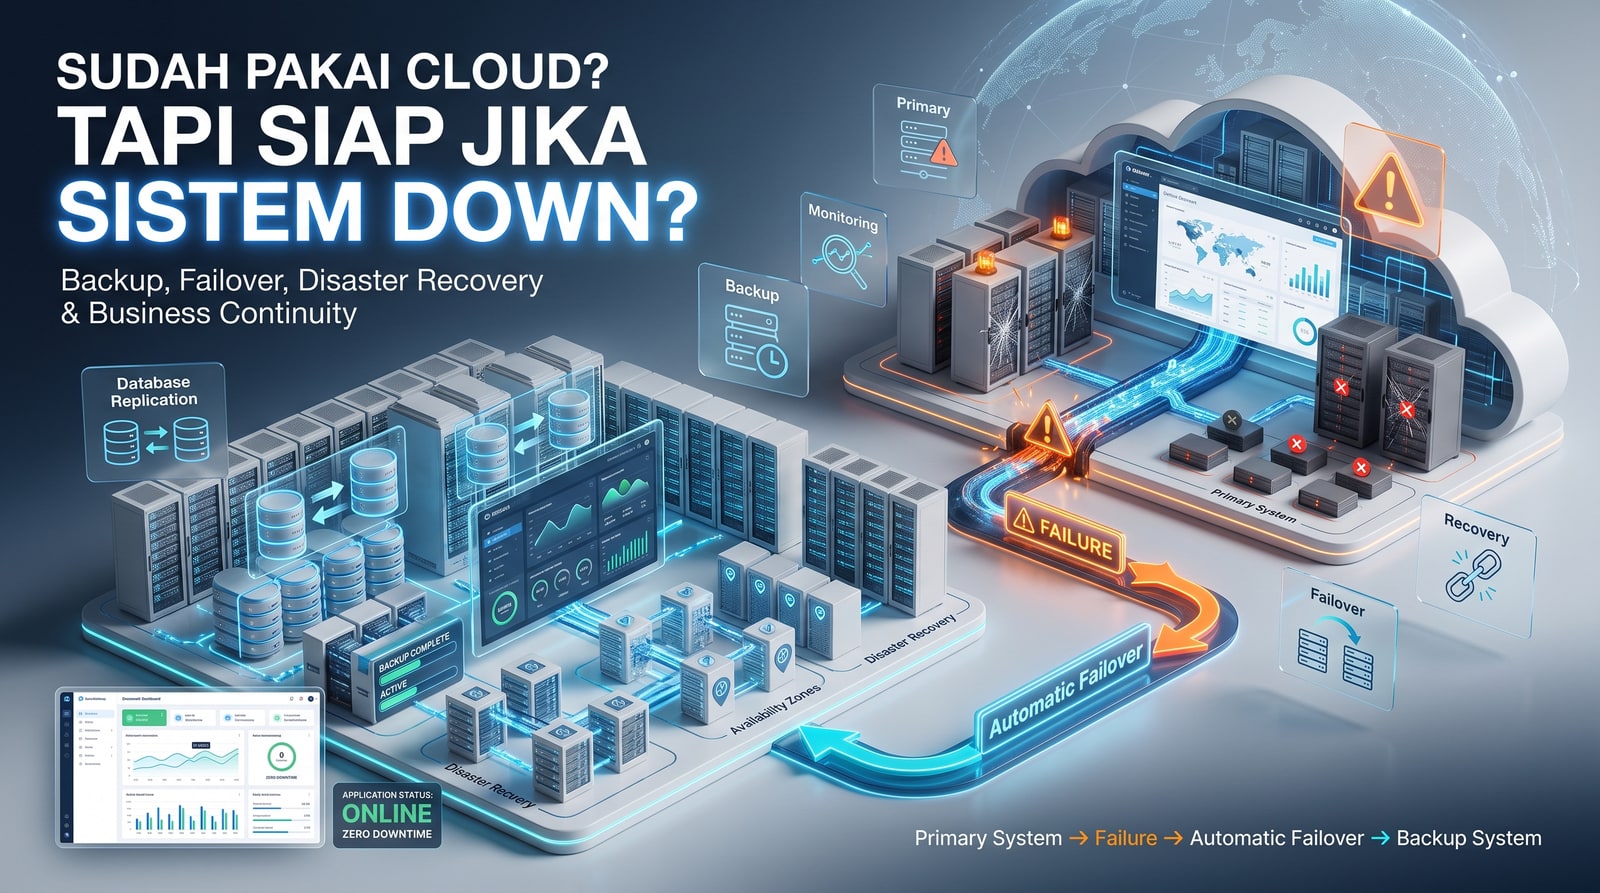
Meskipun perusahaan sudah mengadopsi cloud, kesiapan menghadapi sistem down tidak serta merta terjamin; strategi ketahanan sistem cloud dengan AI yang proaktif adalah kunci untuk mencegah kerugian signifikan dan menjaga `produktivitas perusahaan` tetap optimal. Migrasi ke cloud memang menawarkan fleksibilitas dan skalabilitas, namun tanpa perencanaan matang untuk pemulihan bencana dan arsitektur yang tangguh, risiko downtime justru bisa meningkat.
Ringkasan Utama:
- Adopsi cloud tidak otomatis menjamin ketahanan; perencanaan DR dan HA wajib.
- Pilar ketahanan meliputi arsitektur redundan, backup data, dan monitoring proaktif.
- AI memainkan peran vital dalam deteksi anomali, prediksi kegagalan, dan otomatisasi respons insiden.
- Pengujian rutin DRP (Disaster Recovery Plan) adalah keharusan, bukan pilihan.
- Investasi pada `pemahaman AI` dan SDM adalah fondasi untuk sistem cloud yang tangguh dan produktif.
Mengapa Cloud Saja Tidak Cukup untuk Ketahanan Sistem Anda?
Penggunaan cloud memang mengurangi beban operasional infrastruktur fisik, namun tidak secara otomatis membuat server Anda kebal terhadap kegagalan. Model tanggung jawab bersama (Shared Responsibility Model) di cloud menegaskan bahwa penyedia cloud bertanggung jawab atas keamanan dari cloud, sementara Anda bertanggung jawab atas keamanan di dalam cloud, termasuk data, aplikasi, dan konfigurasi ketahanan. Tanpa arsitektur yang tepat, satu kegagalan di level aplikasi atau konfigurasi bisa melumpuhkan seluruh sistem Anda.
Banyak perusahaan melakukan kesalahan fatal dengan berasumsi bahwa hanya dengan memindahkan server ke cloud, sistem mereka akan langsung memiliki ketersediaan tinggi (High Availability/HA) dan kemampuan pemulihan bencana (Disaster Recovery/DR) yang mumpuni. Padahal, HA dan DR adalah layanan tambahan yang perlu diimplementasikan secara eksplisit dengan desain arsitektur yang cermat. Misalnya, sebuah perusahaan e-commerce yang hanya menempatkan servernya di satu Availability Zone (AZ) dalam sebuah region cloud, akan lumpuh total jika AZ tersebut mengalami gangguan. Ini adalah skenario umum yang sering terjadi, menyebabkan kerugian finansial, reputasi, dan penurunan `produktivitas perusahaan` secara drastis.
Apa Pilar Utama Strategi Ketahanan Sistem Cloud yang Efektif?
Strategi ketahanan sistem cloud dengan AI yang efektif dibangun di atas beberapa pilar fundamental yang saling mendukung, memastikan sistem dapat bertahan dari berbagai gangguan dan pulih dengan cepat. Pilar-pilar ini mencakup desain arsitektur yang redundan, strategi cadangan data yang kokoh, serta monitoring dan respons insiden yang proaktif. Mengabaikan salah satu pilar ini ibarat membangun rumah tanpa fondasi yang kuat, rentan runtuh saat badai datang.
Pilar 1: Arsitektur Redundan dan Terdistribusi
Arsitektur redundan berarti tidak ada satu titik kegagalan (Single Point of Failure/SPOF) dalam sistem Anda. Ini dicapai dengan mendistribusikan beban kerja Anda ke berbagai lokasi fisik yang terisolasi secara logis. Untuk lingkungan cloud, ini berarti memanfaatkan Multi-Availability Zone (AZ) dan bahkan Multi-Region.
- Multi-AZ: Mendistribusikan aplikasi dan data ke setidaknya dua AZ dalam satu region cloud. Jika satu AZ down, aplikasi Anda masih berjalan di AZ lain. Ini adalah standar minimum untuk HA.
- Multi-Region: Untuk ketahanan yang lebih ekstrem terhadap bencana regional, aplikasi didistribusikan ke beberapa region geografis. Ini lebih kompleks dan mahal, namun memberikan perlindungan terhadap kegagalan regional skala besar.
"Membangun arsitektur yang tangguh di cloud bukan hanya tentang ketersediaan, tapi juga kemampuan sistem untuk pulih secara otomatis dan cepat tanpa intervensi manual yang signifikan. Ini adalah investasi vital untuk `produktivitas perusahaan` jangka panjang." - CTO A2M Jaya Teknologi
Pilar 2: Cadangan Data (Backup) dan Pemulihan (Recovery)
Data adalah aset paling berharga perusahaan, dan kehilangannya bisa fatal. Strategi cadangan data yang efektif harus mencakup tidak hanya backup rutin, tetapi juga rencana pemulihan yang teruji. Konsep 3-2-1 backup (3 kopi data, di 2 media berbeda, dengan 1 kopi di luar lokasi) masih relevan di cloud, di mana "luar lokasi" bisa berarti region atau akun cloud yang berbeda.
- RPO (Recovery Point Objective): Berapa banyak data yang boleh hilang (misalnya, data 1 jam terakhir). Ini menentukan frekuensi backup.
- RTO (Recovery Time Objective): Berapa lama waktu yang dibutuhkan untuk mengembalikan sistem beroperasi setelah kegagalan. Ini menentukan kecepatan proses pemulihan.
- Jenis Backup: Snapshot (salinan titik waktu), replikasi database (sinkron/asinkron), backup berbasis file. Pemilihan tergantung pada RPO/RTO yang diinginkan dan sensitivitas data.
Pilar 3: Monitoring Proaktif dan Otomatisasi AI
Sistem yang tangguh membutuhkan mata dan telinga yang selalu waspada. Monitoring proaktif memungkinkan deteksi dini masalah sebelum menjadi krisis. Di sinilah peran AI menjadi sangat krusial. AI dapat menganalisis volume besar log dan metrik secara real-time, mengidentifikasi pola anomali yang mungkin terlewat oleh manusia, dan bahkan memprediksi potensi kegagalan.
Deteksi Anomali dengan AI: Algoritma machine learning dapat mempelajari perilaku normal sistem Anda. Ketika ada penyimpangan dari pola ini (misalnya, lonjakan tak terduga dalam error rate* atau penurunan performa secara bertahap), AI dapat memberikan peringatan dini.
- Prediksi Kegagalan: Dengan menganalisis data historis performa dan log, AI dapat memprediksi komponen mana yang mungkin akan gagal, memungkinkan tindakan preventif sebelum downtime terjadi.
Bagaimana Menguji Kesiapan Sistem Cloud Anda Secara Realistis?
Memiliki rencana ketahanan yang bagus di atas kertas tidak berarti apa-apa jika belum pernah diuji. Pengujian adalah langkah krusial untuk memvalidasi strategi dan mengidentifikasi celah. Metode pengujian harus realistis, bahkan menantang, untuk memastikan sistem benar-benar siap menghadapi skenario terburuk.
Salah satu pendekatan terbaik adalah Chaos Engineering, sebuah praktik yang dipopulerkan oleh Netflix. Ini melibatkan injeksi kesalahan secara sengaja ke dalam sistem produksi untuk menguji ketahanannya. Misalnya, mematikan server secara acak, memutuskan koneksi jaringan antar layanan, atau mensimulasikan kegagalan database. Tujuannya bukan untuk menyebabkan kerusakan, melainkan untuk belajar dari kegagalan yang terkontrol dan memperbaiki kelemahan sebelum terjadi insiden nyata.
Selain Chaos Engineering, simulasi pemulihan bencana secara berkala juga wajib dilakukan. Ini melibatkan latihan penuh untuk mengaktifkan sistem cadangan, memulihkan data dari backup, dan menguji fungsionalitas aplikasi di lingkungan pemulihan. Penting untuk mendokumentasikan setiap langkah, mengukur RPO dan RTO yang sebenarnya tercapai, dan melakukan post-mortem untuk setiap pengujian guna perbaikan berkelanjutan. Tanpa pengujian, DRP Anda hanyalah dokumen di folder yang tidak terbukti keandalannya.
Berikut adalah beberapa metrik kunci yang perlu diukur saat pengujian:
| Metrik | Deskripsi | Contoh Target |
|---|---|---|
| RTO | Waktu maksimal yang diizinkan untuk mengembalikan sistem beroperasi | 15 menit |
| RPO | Jumlah data maksimal yang boleh hilang selama insiden | 5 menit |
| MTTD (Mean Time To Detect) | Waktu rata-rata untuk mendeteksi adanya insiden | 1 menit |
| MTTR (Mean Time To Resolve) | Waktu rata-rata untuk memulihkan sistem setelah insiden terdeteksi | 30 menit |
| Uptime % | Persentase waktu sistem beroperasi normal | 99.99% (empat sembilan) |
Membangun Rencana Pemulihan Bencana (DRP) di Lingkungan Cloud
Rencana Pemulihan Bencana (DRP) adalah dokumen komprehensif yang menguraikan langkah-langkah yang harus diambil untuk melanjutkan operasi bisnis setelah bencana. Di lingkungan cloud, DRP harus mencakup aspek teknis dan non-teknis, mengingat fleksibilitas dan kompleksitas yang ditawarkan penyedia cloud. Proses ini dimulai dari analisis dampak bisnis (Business Impact Analysis/BIA) untuk mengidentifikasi sistem kritis dan menetapkan RPO/RTO yang realistis.
Komponen inti DRP meliputi:
- Tim Pemulihan: Siapa yang bertanggung jawab, dengan peran dan tanggung jawab yang jelas.
- Prosedur Komunikasi: Bagaimana tim, manajemen, pelanggan, dan stakeholder lainnya akan diinformasikan.
- Prosedur Teknis: Langkah-langkah detail untuk failover, pemulihan data, konfigurasi ulang jaringan, dan validasi aplikasi.
- Daftar Kontak: Informasi kontak personel kunci, vendor, dan penyedia layanan cloud.
- Lokasi Cadangan: Informasi tentang lokasi backup data dan lingkungan pemulihan.
- Pengujian & Pemeliharaan: Jadwal pengujian DRP dan prosedur pembaruan.
- Cold Standby: Biaya terendah. Lingkungan pemulihan minimal, butuh waktu lama untuk diaktifkan (RTO > jam). Data dipulihkan dari backup.
- Warm Standby: Biaya moderat. Lingkungan pemulihan sebagian aktif, data direplikasi secara berkala (RTO ~ menit hingga jam).
- Hot Standby: Biaya tertinggi. Lingkungan pemulihan sepenuhnya aktif dan siap mengambil alih seketika (RTO < menit). Data direplikasi secara real-time.
Peran AI dalam Mengamankan dan Mengoptimalkan Ketahanan Sistem Cloud
Integrasi AI bukan lagi kemewahan, melainkan kebutuhan esensial dalam membangun ketahanan sistem cloud dengan AI yang modern dan proaktif. AI memberikan kemampuan yang melampaui monitoring tradisional, memungkinkan organisasi untuk mendeteksi, memprediksi, dan merespons ancaman serta kegagalan sistem dengan kecepatan dan akurasi yang tak tertandingi, secara langsung meningkatkan `produktivitas perusahaan`.
Deteksi Ancaman Keamanan & Anomali: AI dapat menganalisis pola lalu lintas jaringan, log keamanan, dan perilaku pengguna untuk mengidentifikasi aktivitas mencurigakan atau serangan siber secara real-time*. Ini jauh lebih efisien daripada deteksi berbasis aturan manual dan sangat penting dalam mencegah pelanggaran data yang dapat menyebabkan downtime besar.
Otomatisasi Respons Insiden: Setelah anomali terdeteksi, AI dapat memicu respons otomatis. Misalnya, mengisolasi instance yang terinfeksi, memblokir alamat IP berbahaya, atau memicu failover* ke sistem cadangan. Otomatisasi ini mengurangi MTTR (Mean Time To Resolve) secara drastis, meminimalkan durasi downtime.
- Prediksi Kegagalan Infrastruktur: Dengan menganalisis metrik performa historis (CPU usage, memory, disk I/O) dan data log, algoritma AI dapat memprediksi kapan sebuah komponen infrastruktur (server virtual, database) kemungkinan akan mengalami kegagalan. Ini memungkinkan tim IT untuk melakukan pemeliharaan prediktif dan mencegah downtime sebelum terjadi.
- Optimalisasi Sumber Daya dan Biaya: AI juga dapat mengoptimalkan penggunaan sumber daya cloud, secara otomatis menyesuaikan kapasitas berdasarkan permintaan. Ini tidak hanya meningkatkan performa dan ketersediaan, tetapi juga mengurangi biaya operasional, sehingga `produktivitas perusahaan` tidak terganggu oleh masalah anggaran.
Studi Kasus: Transformasi Ketahanan Sistem UMKM "Griya Digital"
Griya Digital, sebuah UMKM di bidang e-learning dengan 10.000+ pengguna aktif, awalnya menghadapi tantangan besar. Meskipun sudah di cloud, sistem mereka sering mengalami downtime mendadak, terutama saat puncak trafik. Backup data tidak konsisten, dan pemulihan membutuhkan waktu berjam-jam, menyebabkan kerugian reputasi dan finansial yang signifikan, serta `produktivitas perusahaan` yang terhambat.
A2M Jaya Teknologi membantu Griya Digital merancang ulang arsitektur cloud mereka. Solusi yang diterapkan meliputi:
Migrasi ke Arsitektur Multi-AZ: Aplikasi dan database didistribusikan ke dua Availability Zone yang berbeda dengan load balancer* di depannya.
Backup Otomatis & Replikasi Database: Implementasi backup harian ke storage* terpisah dan replikasi database secara asinkron untuk RPO di bawah 15 menit.
Sistem Monitoring Berbasis AI: Menggunakan solusi monitoring yang diperkuat AI untuk deteksi anomali performa dan keamanan. AI secara otomatis memicu alert ke tim on-call dan bahkan mencoba restart layanan yang stuck*.
Pengujian DRP Rutin: Latihan pemulihan bencana dilakukan setiap kuartal, menguji failover* dan pemulihan data, dengan target RTO 30 menit.
Hasilnya sangat positif. Griya Digital mencapai uptime 99.95%, mengurangi insiden downtime hingga 80%. Waktu pemulihan (RTO) rata-rata turun dari 4 jam menjadi 25 menit. Pengguna merasakan layanan yang lebih stabil, kepercayaan meningkat, dan tim operasional dapat fokus pada inovasi daripada pemadaman. Investasi ini terbukti meningkatkan `produktivitas perusahaan` secara keseluruhan dan memberikan ROI yang jelas dalam waktu 18 bulan. Kisah sukses seperti ini dapat Anda temukan juga di halaman portfolio A2M Jaya Teknologi kami.
Kesalahan Umum dalam Strategi Ketahanan Cloud & Cara Menghindarinya
Bahkan dengan niat terbaik, perusahaan sering melakukan kesalahan yang dapat merusak strategi ketahanan cloud mereka. Mengidentifikasi dan menghindari jebakan ini adalah kunci untuk membangun sistem yang benar-benar tangguh dan menjaga `produktivitas perusahaan`.
- Mengabaikan Shared Responsibility Model: Asumsi bahwa cloud provider akan mengurus segalanya. Ingat, keamanan aplikasi, data, dan konfigurasi ketahanan adalah tanggung jawab Anda. Selalu pahami batasan tanggung jawab penyedia cloud Anda.
- Tidak Menguji DRP Secara Rutin: DRP yang tidak pernah diuji sama saja dengan tidak punya DRP. Uji secara berkala, minimal setahun sekali, dan pastikan seluruh tim terlibat dan memahami perannya.
- Fokus Hanya pada Teknologi, Melupakan Proses & SDM: Teknologi canggih tidak akan efektif tanpa proses yang jelas dan tim yang terlatih. Investasi pada pelatihan tim dan `pemahaman AI` adalah sama pentingnya dengan investasi pada tool.
- RPO/RTO yang Tidak Realistis: Menetapkan RPO/RTO yang terlalu ambisius tanpa investasi yang sepadan akan menyebabkan kegagalan. Sesuaikan target dengan anggaran dan kebutuhan bisnis Anda.
- Kurangnya Dokumentasi: Prosedur pemulihan yang tidak terdokumentasi dengan baik akan menghambat respons saat krisis, terutama jika personel kunci tidak tersedia.
Kesimpulan
Adopsi cloud adalah langkah maju, namun memastikan ketahanan sistem cloud dengan AI adalah tantangan berkelanjutan yang membutuhkan strategi komprehensif. Ini bukan hanya tentang mencegah downtime, tetapi juga tentang menjaga `produktivitas perusahaan`, melindungi reputasi, dan memastikan kelangsungan bisnis di tengah ketidakpastian. Dengan mengimplementasikan arsitektur redundan, strategi backup yang kuat, monitoring proaktif yang diperkuat AI, dan DRP yang teruji, Anda dapat membangun fondasi digital yang tangguh.
Investasi pada `pemahaman AI` dan SDM yang kompeten adalah kunci untuk memaksimalkan potensi teknologi ini. Jangan menunggu bencana terjadi untuk menyadari pentingnya ketahanan. Mulailah perencanaan hari ini. Butuh panduan lebih lanjut atau ingin mengimplementasikan solusi ketahanan cloud yang cerdas? Hubungi A2M Jaya Teknologi untuk konsultasi gratis dan bagikan artikel ini di media sosial Anda untuk menyebarkan kesadaran tentang pentingnya ketahanan sistem cloud!